Lo medimos en nuestra propia empresa: siete preguntas reales, con HubSpot, Linear y Slack conectados directamente, frente a nuestro brain y frente al brain limitado a una sola llamada. 84 ejecuciones. El montaje completo, al final.
Una herramienta: gana lo directo
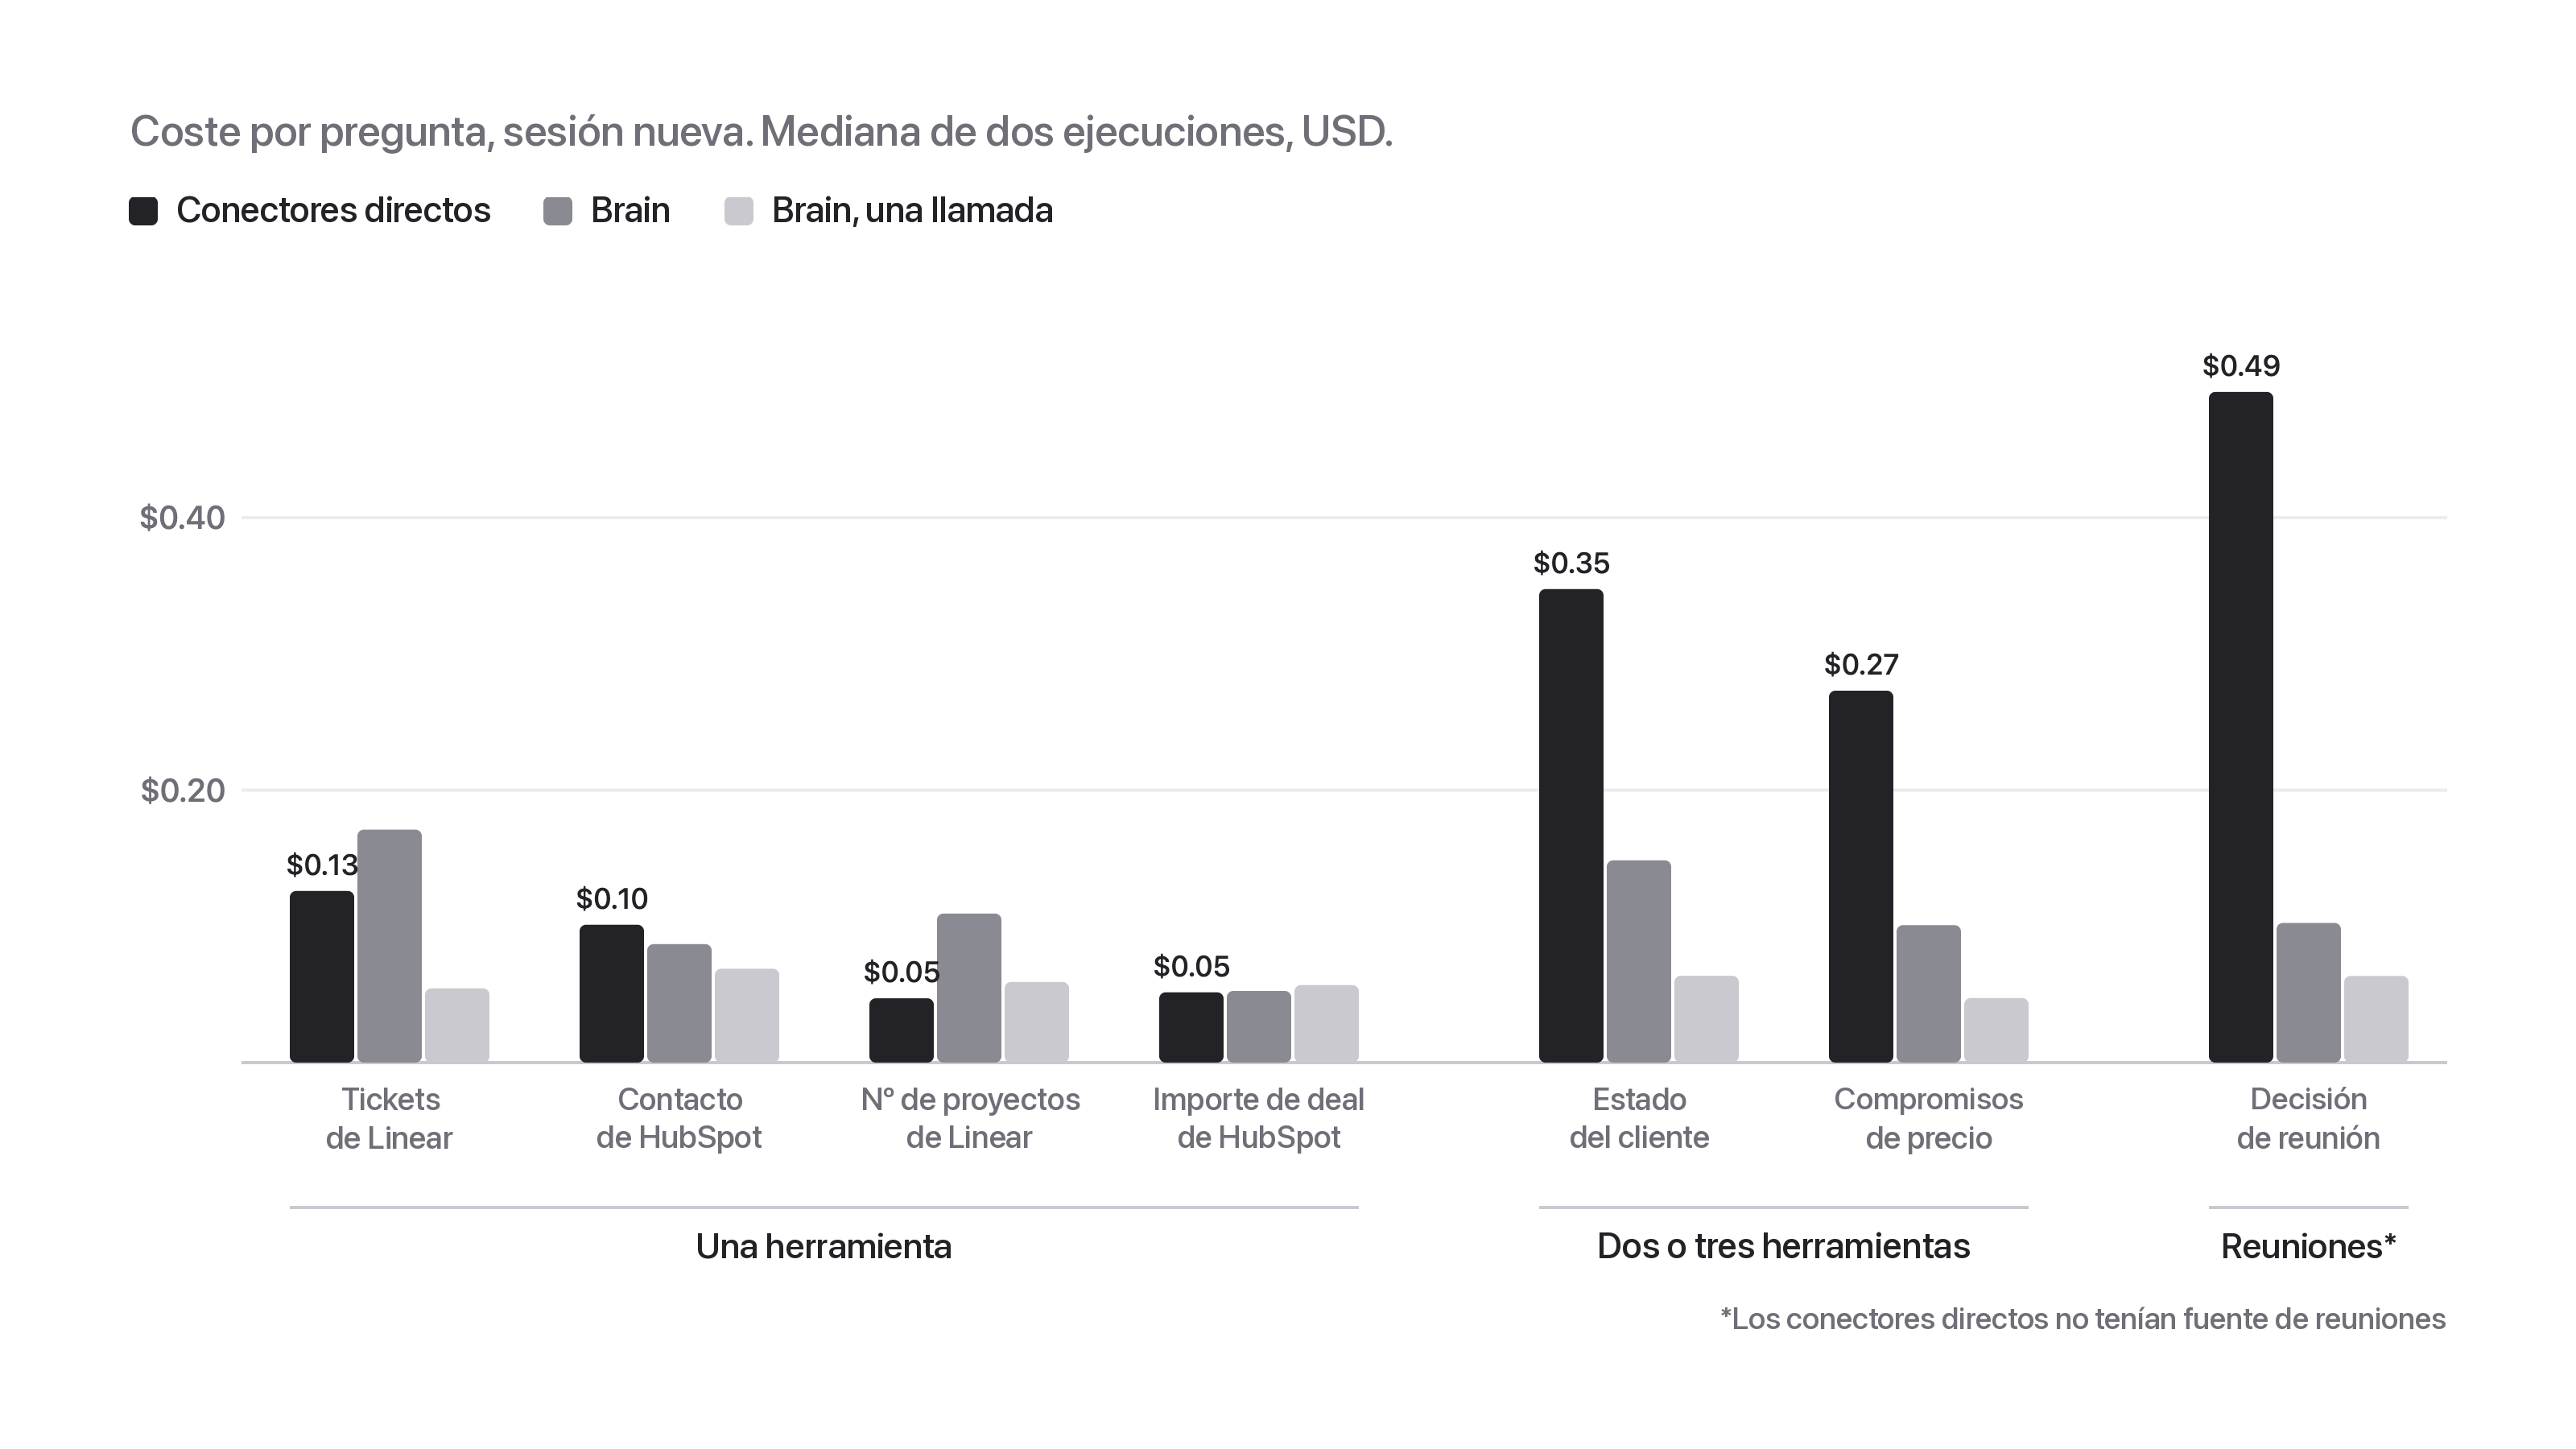
En las cuatro preguntas de una sola herramienta, lo directo fue más barato o empató en tres. Mediana de $0.076 por pregunta frente a $0.098 pasando por el brain, alrededor de un 22% menos. El asistente llama a la herramienta, recibe el registro y responde. Una capa en medio solo añade su propio coste.
Dos o tres herramientas: el coste se multiplica
Mismo gráfico, grupo del medio. «Estado del cliente» costó $0.35 en directo frente a $0.15 por el brain (2.3x). «Compromisos de precio», $0.27 frente a $0.10 (2.7x). La pregunta de la reunión fue la más cara de todas, pero en directo no había ninguna fuente de reuniones donde buscar, así que la comparación no es justa: el asistente siguió buscando algo que no estaba.
La razón está en cómo funciona el bucle de un agente. En cada paso, el modelo vuelve a leer todo el contexto: el system prompt, las definiciones de las herramientas y todo lo que han devuelto hasta ese momento. Una búsqueda en Slack devuelve hilos enteros (aquí, 20k caracteres en una sola llamada), HubSpot devuelve registros completos, y todo eso se queda en el contexto hasta que termina la pregunta.
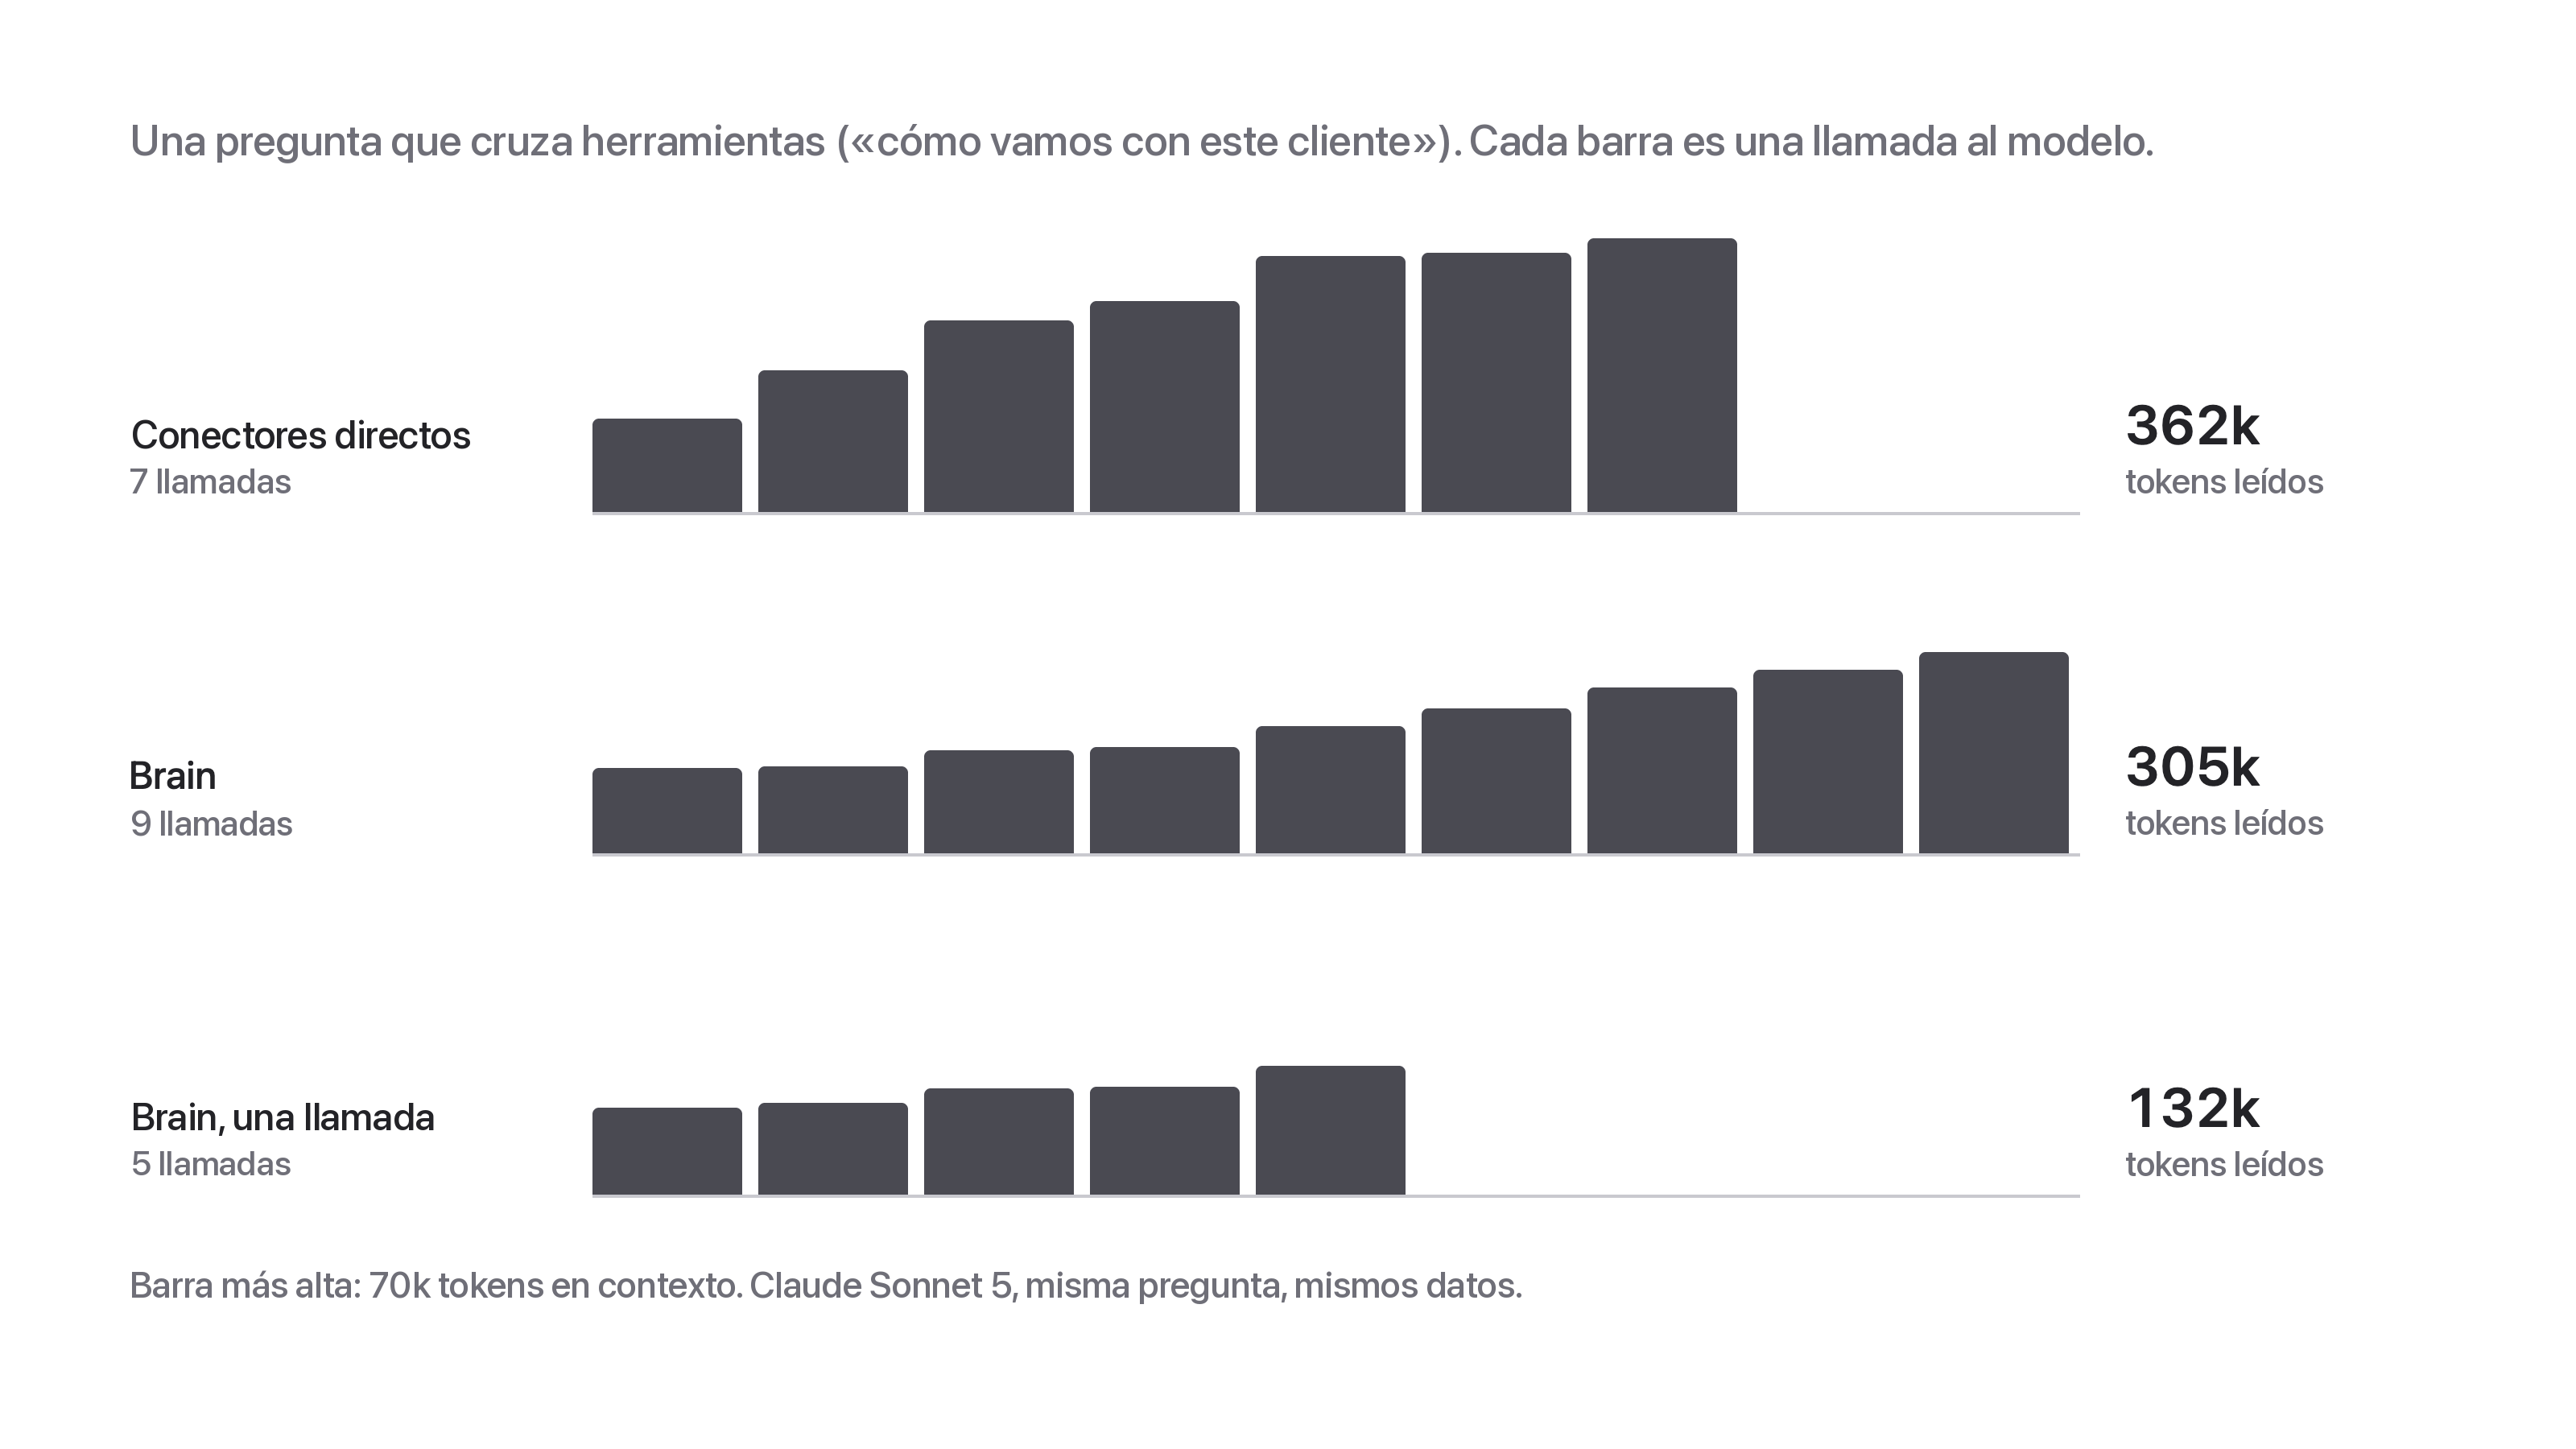
Cada barra es una llamada al modelo, y su altura es lo que el modelo tuvo que leer en ese paso. El coste total es, más o menos, la suma de las barras. Y esta ejecución es de las buenas para lo directo: en la otra repetición de la misma pregunta hizo 13 llamadas y leyó 862k tokens.
Conversaciones largas: el efecto se acumula
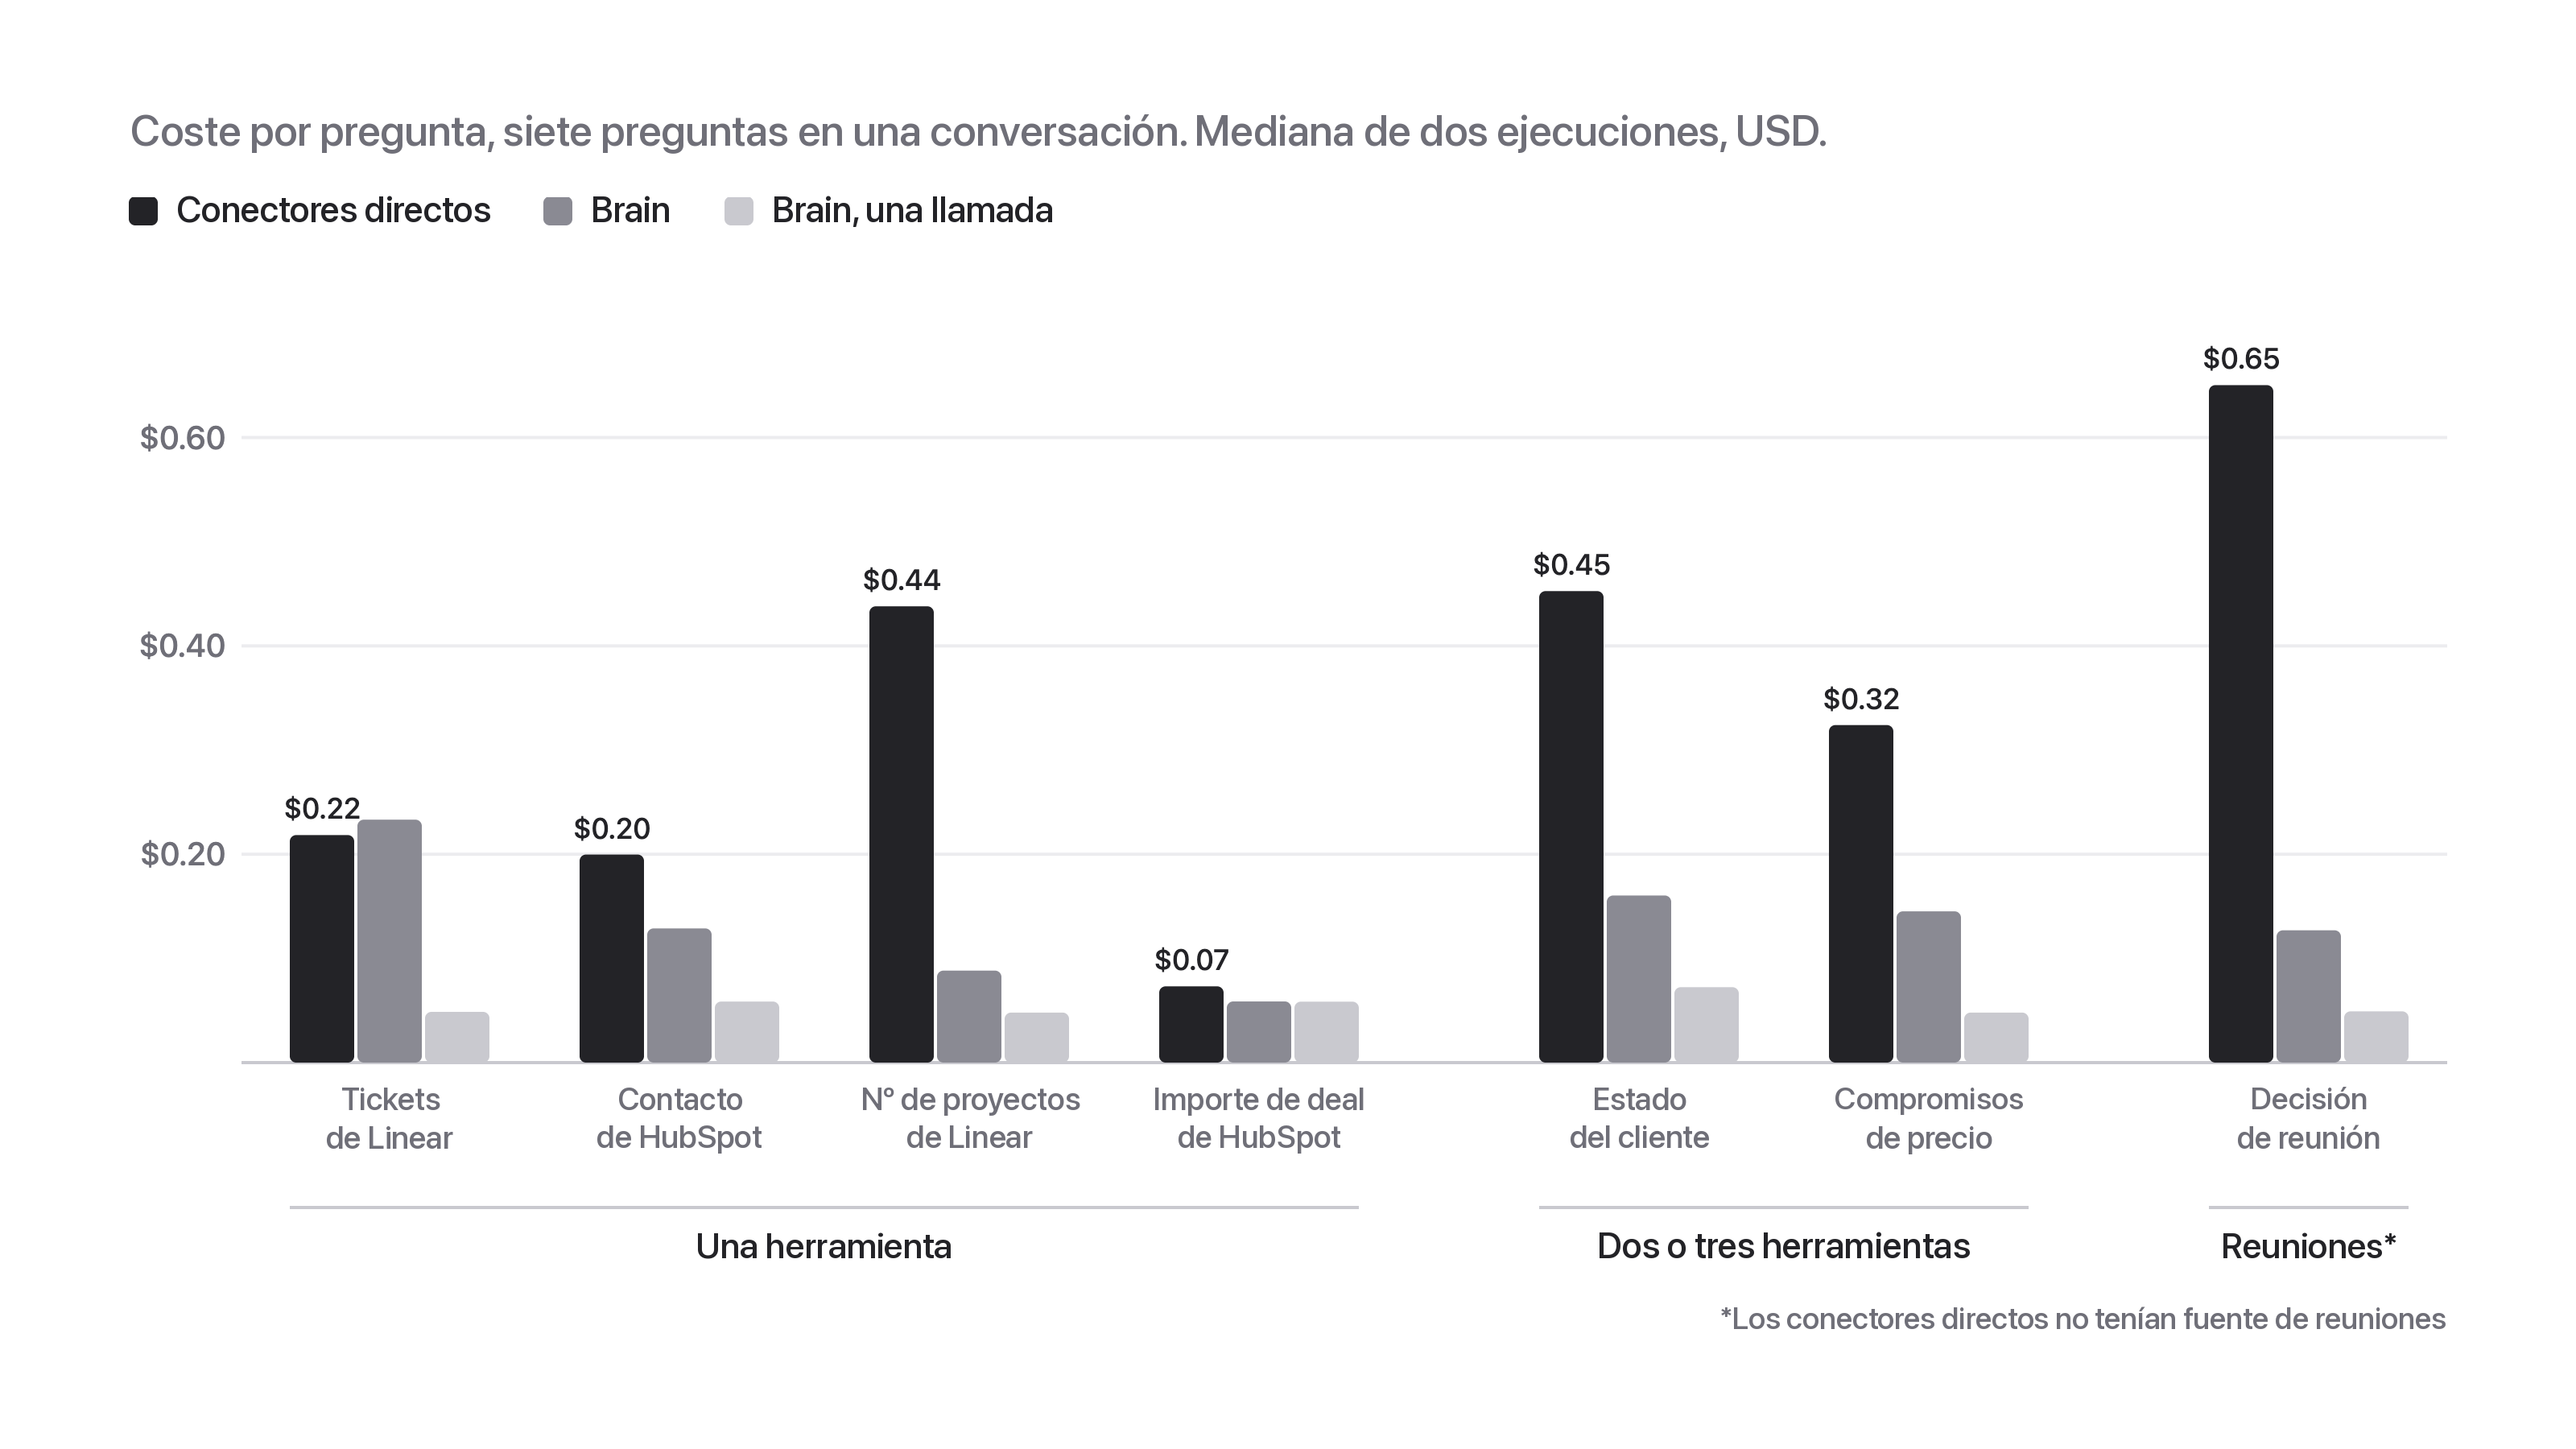
Dentro de una misma conversación, el contexto de las preguntas anteriores también viaja. Mediana del coste por pregunta: $0.32 en directo, $0.13 con el brain y $0.05 con una llamada. Es decir, 2.5x y 6.6x. Lo directo fue lo más caro de los tres en seis de las siete preguntas, incluidas tres de las de una sola herramienta que en una sesión nueva salían baratas.
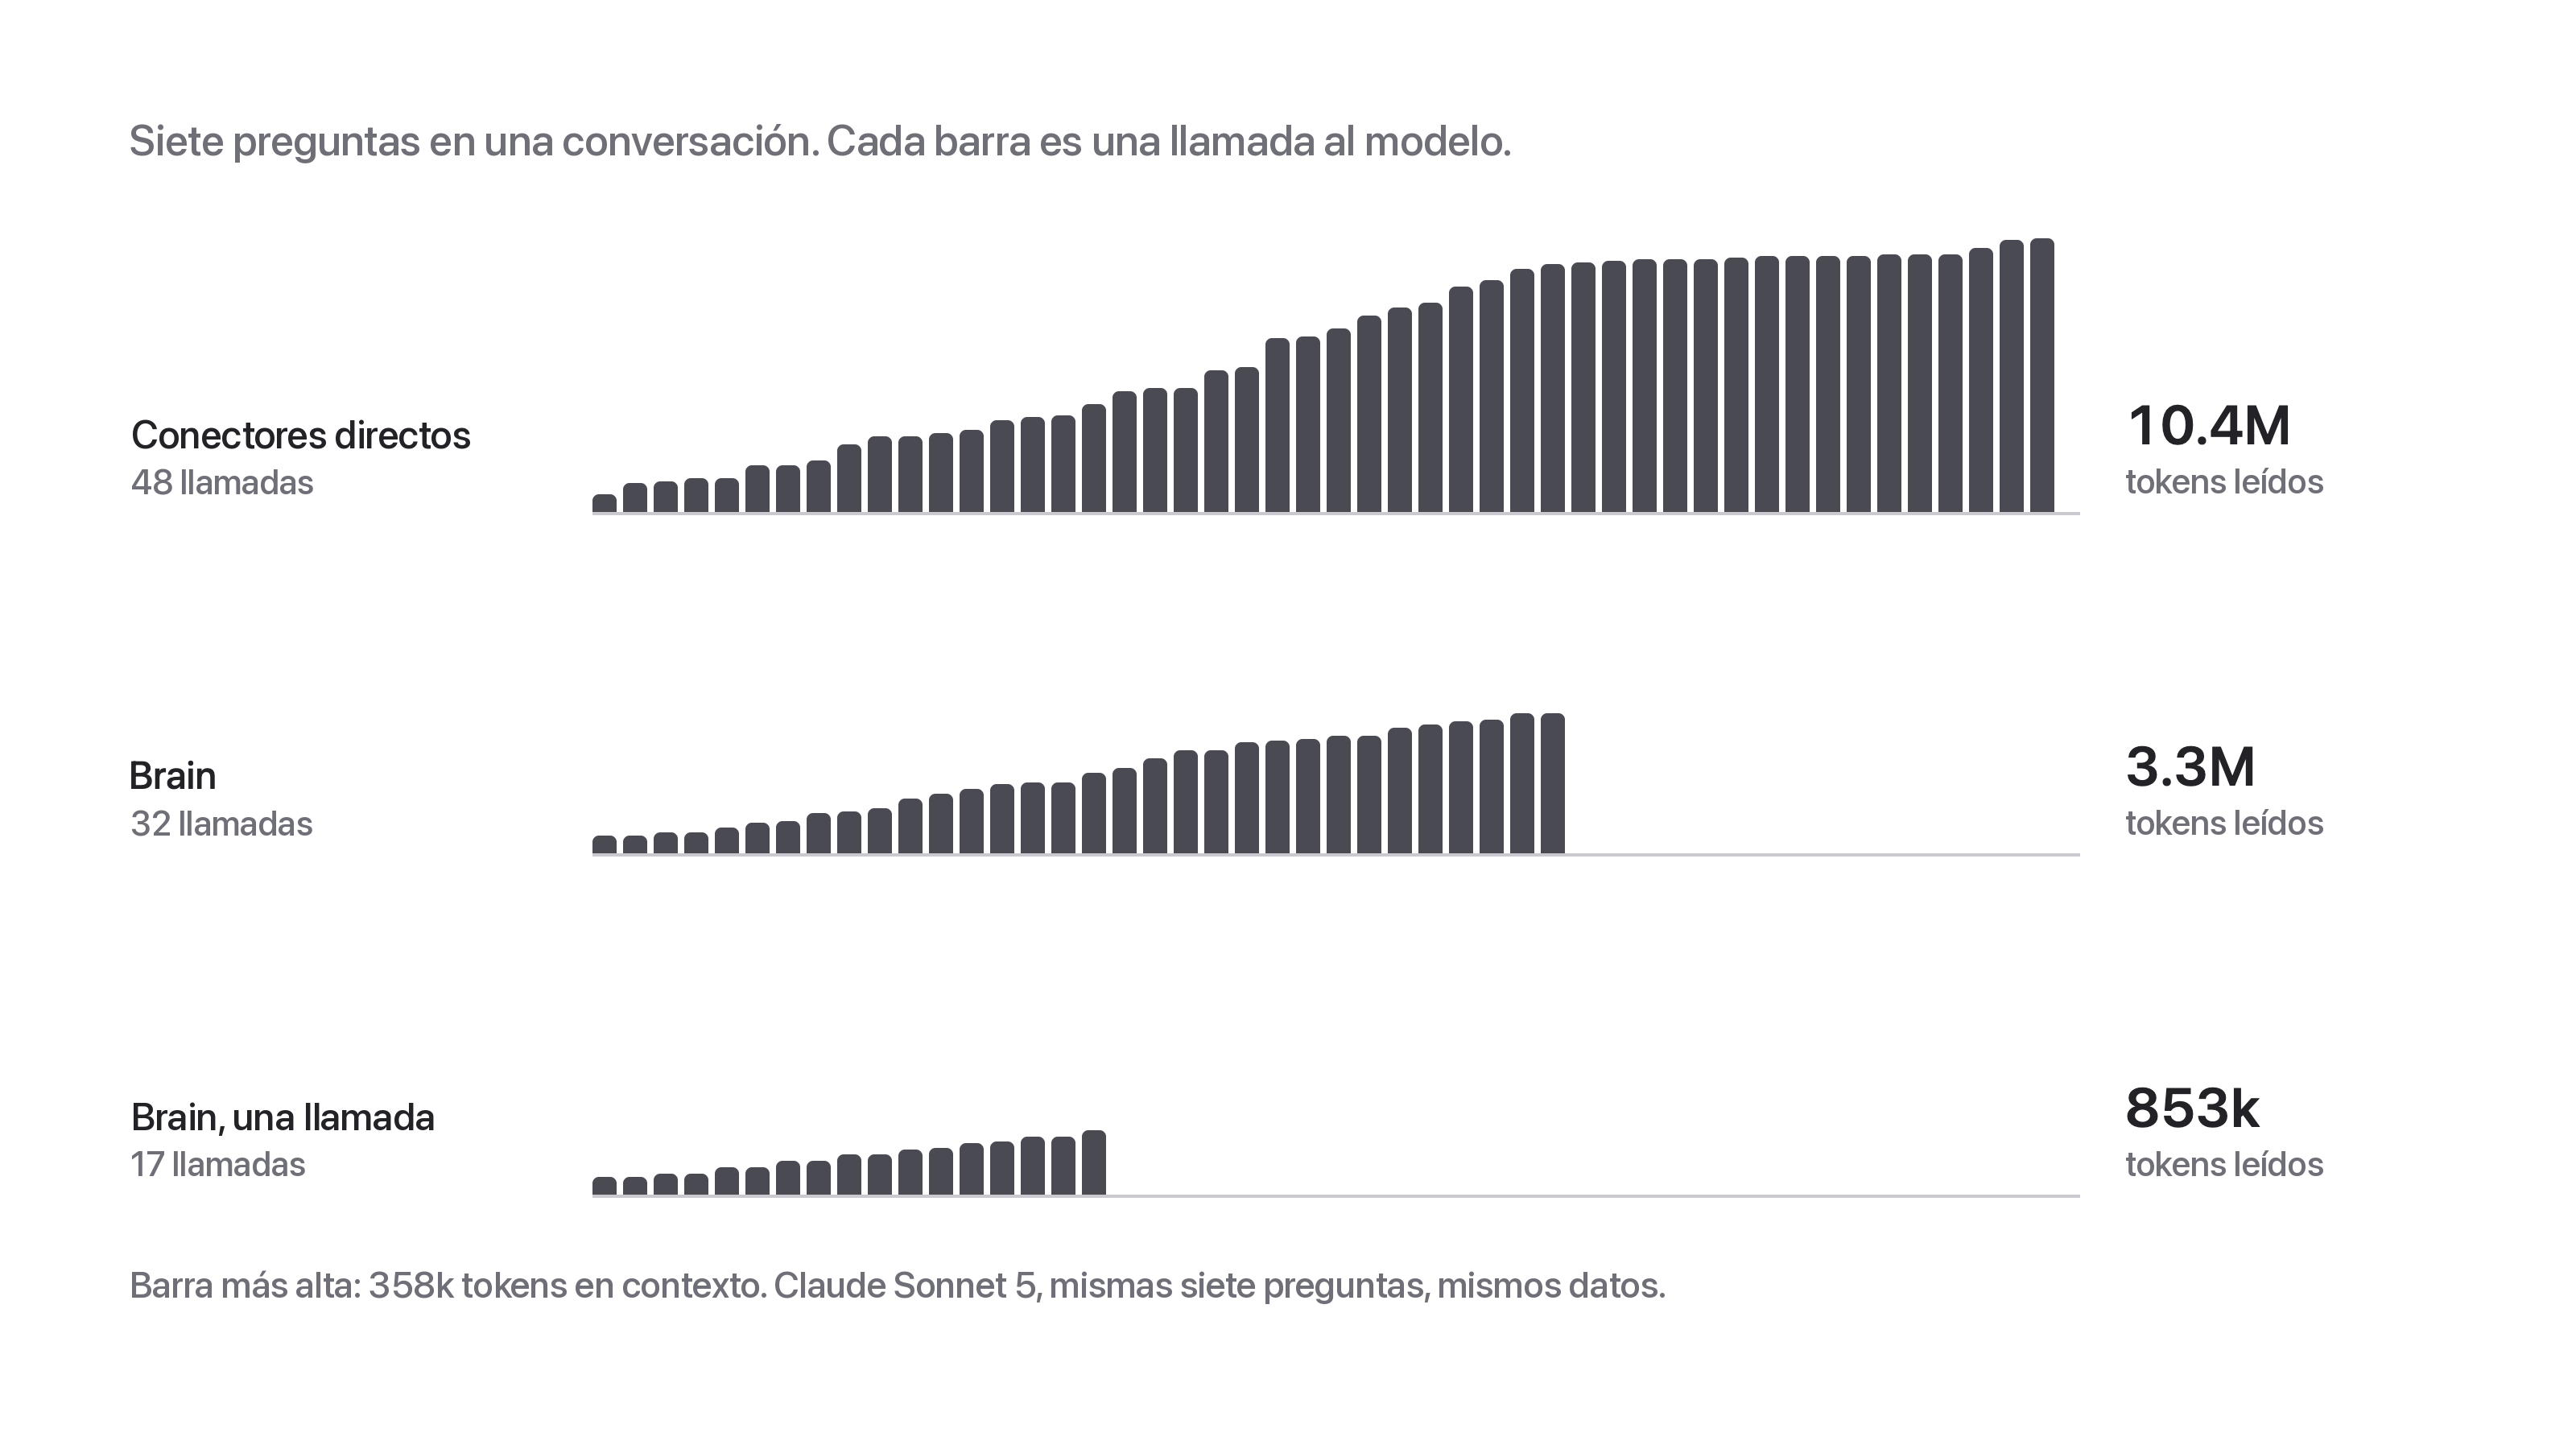
La cadena completa: 48 llamadas al modelo en directo frente a 17 con una llamada, con el contexto subiendo hasta los 358k tokens. En tokens leídos, 12x (10.4M frente a 853k). En dinero, 8x ($3.23 frente a $0.40), porque la mayoría de esos tokens son lecturas de caché, que se cobran a una décima parte de la entrada normal.
Límites
- Conversación larga, coste, directo frente a brain: se sostiene estadísticamente (p=0.047).
- Conversación larga, coste, directo frente a una llamada: se sostiene estadísticamente (p=0.016).
- Conversación larga, llamadas al modelo (9 frente a 4 por pregunta): no se sostiene (p=0.09).
- Sesión nueva, coste (brain ~19% más barato): no se sostiene (p=0.38).
Siete preguntas es una muestra pequeña. Donde p está por encima de 0.05, quedaos solo con la dirección. Además es nuestra propia empresa y nuestro propio producto, y otro montaje dará otros números. Lo que sí espero que se repita es la forma: las preguntas de una sola herramienta no necesitan una capa, y las que cruzan herramientas y las sesiones largas son donde la salida en bruto de las herramientas se come el presupuesto.
Montaje
Siete preguntas de nuestro trabajo: cuatro se responden con una sola herramienta, dos cruzando CRM, tickets y Slack, y una solo con notas de reuniones. Tres montajes sobre Claude Sonnet 5: directo (servidores MCP de HubSpot, Linear y Slack, en solo lectura), brain (alimentado por esas mismas herramientas) y brain limitado a una llamada por pregunta. Cada pregunta en una sesión nueva y las siete en una sola conversación, dos repeticiones, 84 ejecuciones. El protocolo se escribió antes de la primera ejecución.
Las primeras rondas se contaminaron con mi propia configuración de Claude Code (hooks en los settings, instrucciones a nivel de organización), así que ahora ejecutamos con una API key, con los settings de usuario desactivados y un smoke test antes de cada ronda.
guest@gurusup > /posts
guest@gurusup > /install · conecta Gurusup Brain a tus agentes
Empieza - gratis