En GuruSup nos encontramos con una frontera incómoda: parte de la lógica vivía en nuestro servidor MCP y parte en nuestro Assistant, que consume ese MCP. Queríamos que este último fuera un cliente más. Pero compartir herramientas no bastaba para compartir el procedimiento.
Un cliente puede conocer las mismas tools y aun así no saber qué contexto reunir primero, cuándo comprobar algo o cómo interpretar el resultado. Cambiar de cliente hace visible lo que el protocolo transporta y lo que habíamos dejado fuera. El MCP debería funcionar igual y rendir de forma parecida, sea cual sea el cliente.
¿Dónde debe vivir ese manual para que pueda viajar con las herramientas?
Mismas tools, distinto recorrido
Imagina una petición habitual a un agente conectado a nuestro MCP: «Añade al agente de soporte que no prometa reembolsos sin revisar antes el pedido».
Un cliente lee primero el prompt actual, localiza la sección de devoluciones e inserta la regla justo después. Luego lo relee para confirmar que el resto sigue igual. Otro escribe un prompt nuevo desde cero, con la regla incluida, y lo guarda en lugar del anterior: la regla entra, pero por el camino desaparece una sección, o la regla nueva choca con otra que ya estaba. Ambos tienen acceso al mismo servidor y ambos acaban con un agente que responde. La diferencia está en el recorrido, y en el segundo caso nadie la ve hasta que un cliente se queja:
No necesitamos respuestas idénticas. Necesitamos que cambiar de cliente no borre pasos importantes ni convierta un cambio pequeño en una reescritura a ciegas.
Conviene separar dos fallos. Si saltarse la lectura previa empeora la edición, falta orientación. Si omitir una validación permite una operación prohibida, falta una condición ejecutable en el servidor. Una skill puede ayudar con el primero; no debe ser la defensa del segundo.
El manual, en concreto
Para esa tarea, una skill podría contener este procedimiento:
---
name: editar-prompt-de-agente
description: Cambia el prompt de un agente sin romper lo que ya funciona.
---
1. Lee el prompt actual antes de cambiarlo.
2. Para un cambio pequeño, edita solo el fragmento; no reescribas el prompt entero.
3. Usa como ancla un texto que aparezca una sola vez.
4. Después de guardar, relee y confirma que el resto no cambió.
La tool guarda el cambio. La skill prescribe cómo prepararlo, qué tocar y cómo comprobar que no se rompió nada.
Escribirla es lo fácil. Lo difícil empieza después:
- ¿Dónde vive? ¿En el servidor MCP, junto a las tools que describe, o en cada cliente que las usa?
- ¿Cómo llega hasta el modelo? ¿La instala el usuario, la pide el agente o la ofrece el servidor?
- ¿Quién decide cuándo usarla: el host?
- Y si cambio de cliente, ¿viene conmigo o se queda atrás?
El procedimiento debería viajar con el MCP. Quien mantiene las tools es quien mejor sabe cómo usarlas. Si cada cliente guarda su propia copia, tendremos tantas versiones como clientes y ninguna al día. Eso no significa que el servidor decida cuándo se usa: activarlo seguirá siendo cosa del cliente.
El resto del artículo responde a esas preguntas en dos tiempos: cómo lo resuelven hoy distintos servidores MCP con workarounds, y qué cambia con la nueva especificación.
¿No bastaban Resources y Prompts?
MCP ya tenía piezas para transmitir conocimiento. El problema no era dónde guardar texto, sino cómo reconocerlo y consumirlo como un procedimiento compartido.
- Tools: describen y ejecutan operaciones. Una descripción puede orientar, pero meter allí un manual transversal duplica contexto y dificulta mantenerlo.
- Resources: exponen datos y archivos. Podían servir un
SKILL.md, pero no había una convención común para identificar su bundle y descubrirlo como skill. - Prompts: ofrecen plantillas invocables, normalmente elegidas por el usuario. No equivalen a descubrir automáticamente un procedimiento relevante.
- Server instructions: orientan sobre el servidor. Poner todos los manuales ahí elimina buena parte del beneficio de cargarlos solo cuando hacen falta.
Volvamos a la edición. Un Resource puede contener la guía de estilo de los prompts; un Prompt, una plantilla para pedir cambios. Todavía hace falta que el cliente sepa que ambos pertenecen al mismo procedimiento y cuándo recuperarlos. Hasta ahora, cada integración podía inventar esa unión.
Los bytes ya podían viajar. Lo que faltaba era una convención compartida para encontrarlos y reconocer su papel.
Por eso Resources no desaparece con las skills: sigue transportando archivos. La extensión añade el contrato específico para descubrir procedimientos que usan esos archivos.
Los workarounds cuentan la misma historia
El manual como tool: Logfire y n8n
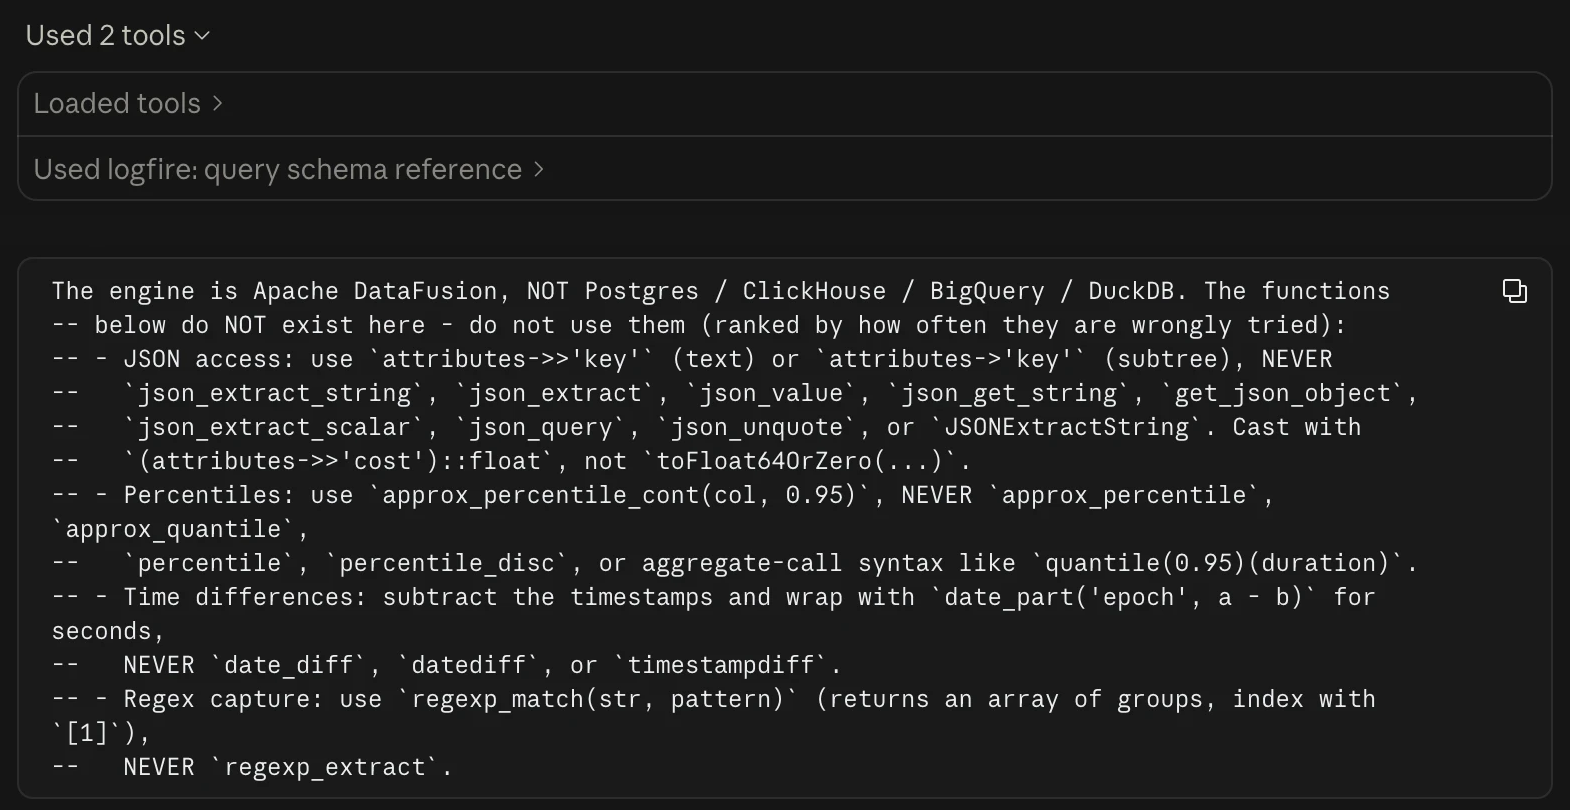
El MCP de Logfire ofrece query_schema_reference para preparar consultas y query_run para ejecutarlas. Su referencia llega a listar las funciones que los modelos intentan usar por error y que su motor no tiene.
El MCP oficial de n8n aplica un patrón parecido: get_workflow_sdk_reference entrega patrones y reglas de construcción, y su documentación recomienda consultarla primero. Permite recuperar secciones concretas; get_workflow_best_practices añade orientación por técnica.
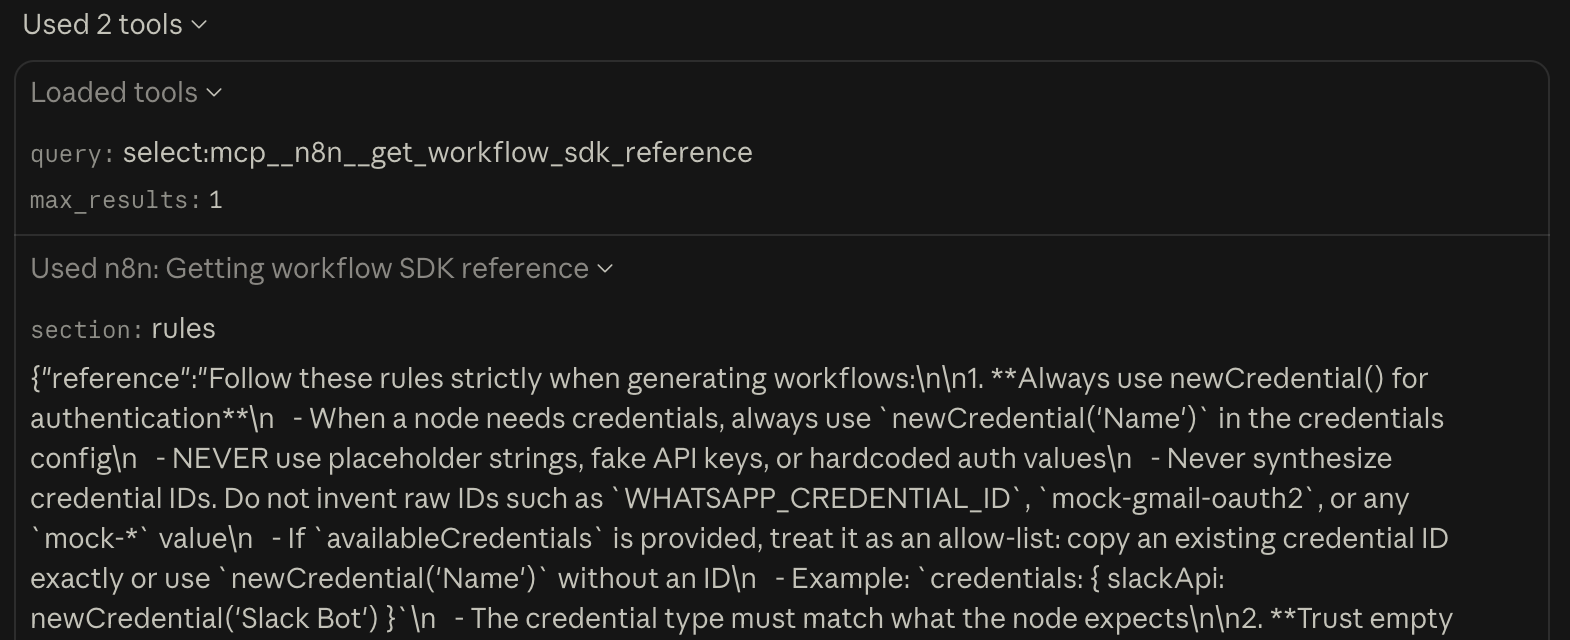
Interpretamos ambos diseños como la misma estrategia: primero recuperar conocimiento; después operar. Logfire entrega contexto para consultar datos; n8n también entrega instrucciones para construir workflows. Ninguno necesita una extensión de skills para ofrecer ese conocimiento bajo demanda.
El límite es compartido: ofrecer un manual y recomendar su lectura no garantiza que el cliente lo consulte ni que siga el procedimiento. Un manual que hay que pedir es un manual que se puede no pedir. Es forzar al modelo a que pida primero el manual y cruzar los dedos 🤞, aunque esta estrategia funciona bastante bien con los modelos actuales.
Brain: el catálogo por adelantado, el manual bajo demanda
En Gurusup Brain combinamos un contrato inicial de uso, el catálogo completo de skills autorizadas con sus descripciones y la recuperación de su contenido bajo demanda. Lo diferido es el manual de cada skill, no el catálogo.
Además, nuestro plugin público distribuye el MCP junto a una skill de entrada que indica consultar primero init, seguir el contrato del servidor y responder basándose en evidencias.
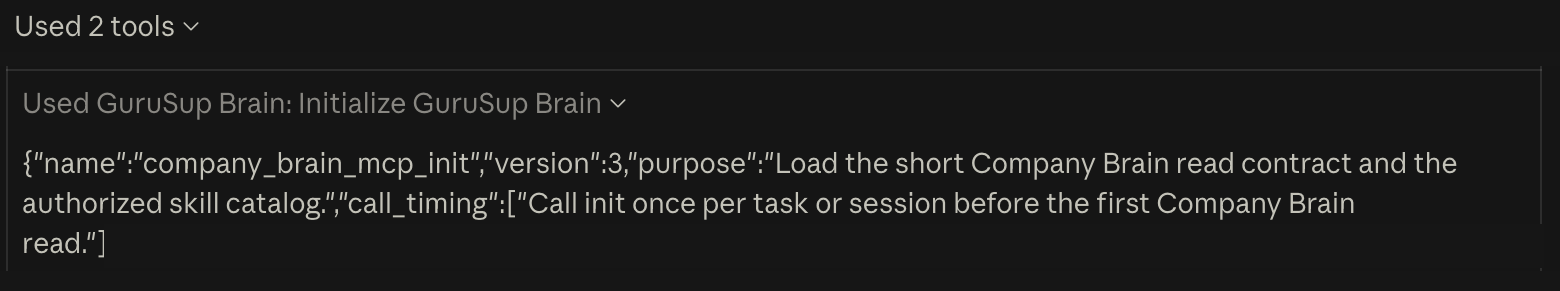
Combinamos así dos workarounds: orientación mediante tools y una skill instalada con el plugin. La instrucción de leer primero sigue dependiendo del cliente; no es una barrera de ejecución.
La lección no fue «todo debe convertirse en una skill». También necesitamos operaciones de alto nivel que eviten obligar a cada cliente a reconstruir cadenas largas. Un buen contrato reduce decisiones innecesarias; un buen procedimiento explica las que quedan.
Los plugins juntan las piezas, pero solo en tu máquina
MongoDB distribuye su servidor MCP mediante plugins para varios agentes y publica aparte sus Agent Skills oficiales. Esto muestra otra respuesta: entregar MCP y skills por canales que el host ya entiende.
Eso permite entregar capacidad y manual juntos, pero la instalación y activación siguen ligadas al ecosistema del cliente. Resuelve una necesidad real sin crear, por sí solo, un contrato entre cualquier servidor y cualquier host. Un plugin lleva el manual hasta tu disco, no hasta el chat de tu cliente.
La CLI, un tercer canal
Varias empresas no eligen entre MCP y skills: suman una CLI. Cumple tres papeles distintos.
Instalar el servidor y el manual. Context7 configura su MCP en cada agente con ctx7 setup. Vercel publica add-mcp, que detecta los agentes instalados y registra su servidor en todos. WorkOS lo hace con workos mcp install. La CLI sabe dónde guarda cada host su configuración; el protocolo no.
Hacer lo que el MCP no puede. Un servidor remoto no ve tu disco ni tu proyecto. La skill de WorkOS dedica una sección a elegir superficie: el MCP para gestionar los recursos de la cuenta, y la CLI para el arranque, la configuración local y los diagnósticos, con un modo pensado para agentes que devuelve JSON. Vercel conecta ambos mundos desde el propio protocolo: un endpoint aparte expone use_vercel_cli, una tool que no ejecuta nada y solo orienta al modelo hacia los comandos de la CLI y su --help. Y cuando una llamada falla, el propio error incluye un objeto cliFallback con el comando de CLI equivalente, su ayuda y sus limitaciones; las descripciones de sus tools también lo anuncian.
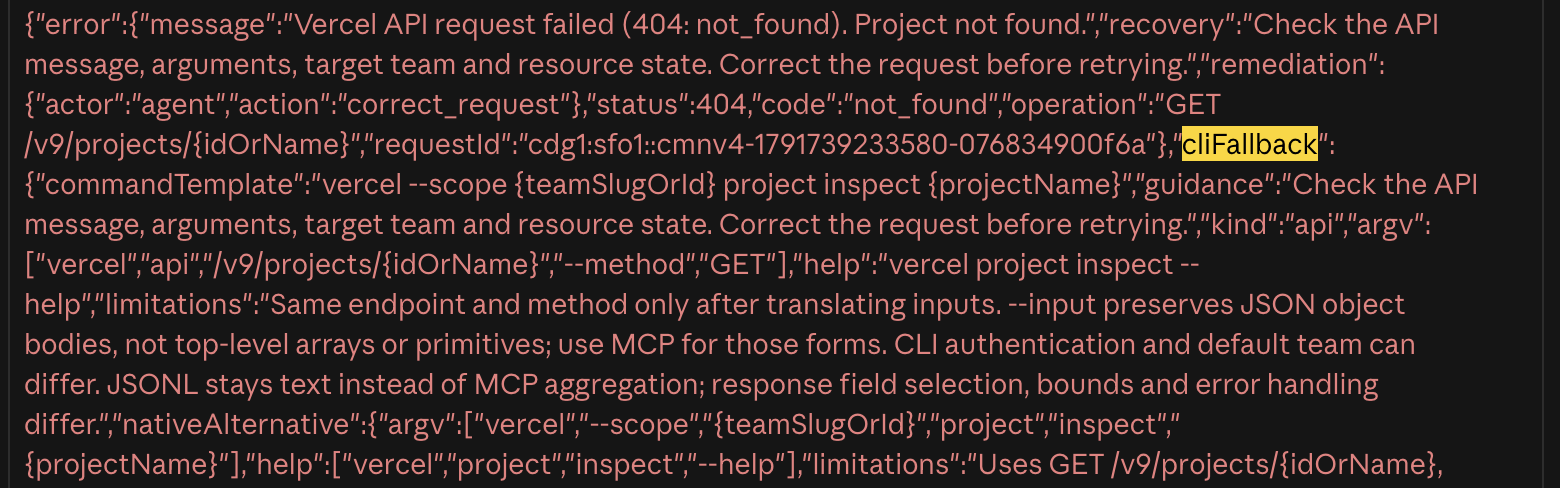
Llevar el procedimiento. Vercel publica CLI Workflows: recorridos completos, como depurar errores 500, revertir un despliegue o configurar un dominio, con la secuencia de comandos y el razonamiento entre pasos, escritos para agentes. Es un manual de procedimiento, pero para la CLI, y vive en la documentación.
Vercel junta cinco canales para un mismo objetivo: un MCP con más de doscientas tools, un plugin, skills instalables, una CLI con workflows para agentes e índices como llms.txt. Es otra forma de llevar el procedimiento fuera de MCP, y otro motivo para estandarizarlo dentro.
Dos mitades del mismo problema
Al comparar estos servidores aparece un patrón. Todos responden a la misma restricción, que no todo cabe en el contexto, pero atacan mitades distintas del problema:
- Capacidades: qué puede hacer el agente.
- Procedimiento: cómo hacerlo bien.
WorkOS es el caso más radical de la primera mitad. Su MCP no expone una tool por operación: ofrece un índice que el agente consulta para descubrir cada operación y sus parámetros, y dos tools genéricas para ejecutarlas, una para consultas y otra para mutaciones. El catálogo parece derivado de su propia API y, dentro del servidor, el manual es solo de referencia: una línea y unos parámetros por operación, sin instrucciones de servidor, resources ni prompts. Su documentación resume la apuesta: «The agent discovers the right operations and runs them for you». Pero preparar el SSO de un cliente toca varias operaciones (crear la organización, añadir sus dominios, registrar a sus administradores y enviarles el enlace de configuración), y el índice no dice en qué orden ni qué comprobar entre una y otra. Cargar menos tools no es lo mismo que transportar el procedimiento para combinarlas.
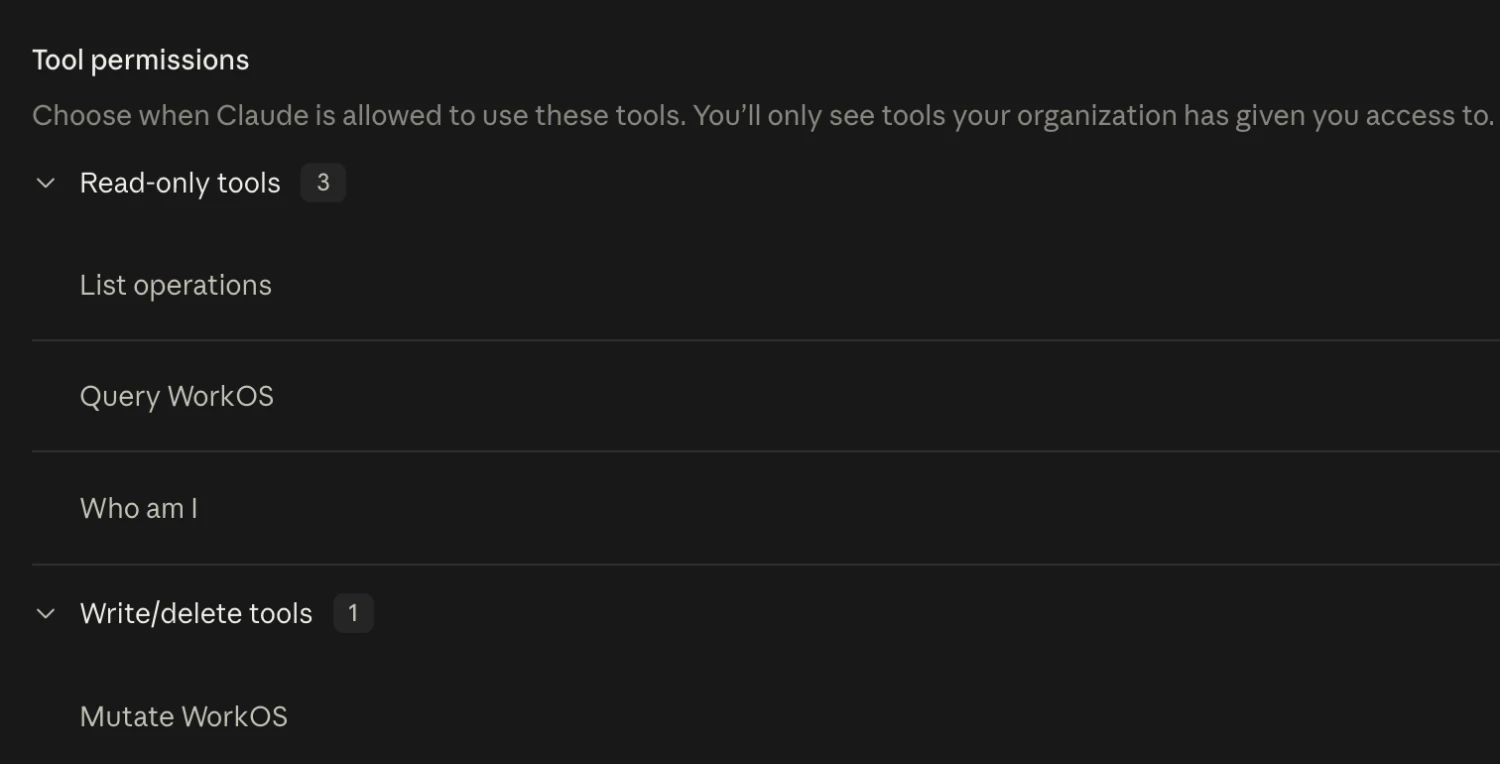
WorkOS sí tiene ese procedimiento, pero fuera del protocolo: su repositorio workos/skills publica una skill con workflows como el onboarding de una organización, empaquetada en plugins para Claude Code, Codex y Cursor.
Logfire, n8n y Context7 atacan la segunda mitad con tools de referencia. Brain cubre las dos: una operación de alto nivel para las capacidades y un catálogo de skills para el procedimiento.
La SEP-2640 estandariza solo la segunda mitad. Es la que WorkOS resuelve con un plugin aparte y la que los demás resolvieron cada uno a su manera. Con la extensión, ese manual podría viajar con el servidor y no depender de que cada host instale el plugin correcto.
La objeción: ¿no bastaba con describir bien las tools?
Es la pregunta obvia. Si el agente ya lee la descripción de cada tool, ¿por qué no meter ahí el procedimiento? Las descripciones bien escritas ayudan, y algunos servidores las aprovechan a fondo: muchas tools de Vercel anuncian en su propia descripción el comando de CLI al que recurrir si la llamada falla. Pero tienen tres límites.
El host decide cuánto se lee. Por defecto, Claude Code recorta las instrucciones de cada servidor y la descripción de cada tool que se carga al inicio a 4.096 caracteres, y a 16.384 si la tool se carga mediante la búsqueda de tools. Y, con la búsqueda de tools activada, al empezar la sesión solo carga los nombres de las tools y las instrucciones de servidor. Si la regla «lee el prompt antes de editarlo» vive al final de una descripción larga, puede que el modelo nunca la llegue a ver.
Un procedimiento no pertenece a una sola tool. Preparar el SSO de un cliente en WorkOS encadena cuatro operaciones. ¿En la descripción de cuál se escribe el orden? Repetirlo en todas multiplica el contexto y garantiza que las copias acaben desincronizadas.
Se paga aunque no se use. Una descripción viaja en cada sesión que carga la tool, se necesite el procedimiento o no. Logfire y n8n no lo resolvieron con descripciones más largas, sino con una tool de referencia que solo se lee cuando hace falta.
La descripción orienta una llamada; el procedimiento explica cómo combinarlas. Hacen falta las dos.
MCP no quería ser un gestor de paquetes
La propuesta original, SEP-2076, quería las skills como primitiva de primer nivel. En la reunión de core maintainers del 24 de junio la votación se aplazó: archivos empaquetados, permisos, scripts y el miedo a convertir MCP en un package manager. Una semana después, el Working Group recortó el alcance: cada archivo sigue siendo un Resource y la extensión solo resuelve discovery e identidad.
Acordar cómo entregar un manual no exige acordar cómo instalar paquetes ni ejecutar código remoto.
La SEP-2640 entrega el manual, no lo hace cumplir
La SEP-2640, con estado Final, define una extensión, no una nueva primitiva del núcleo:
skills/listdescubre entradas y metadata.skills/getobtiene la entrada de una skill por URI: su metadata y los digests de sus archivos.resources/readrecupera instrucciones y archivos auxiliares.resources/directory/readpermite navegar directorios si está soportado; es opcional.
Con el ejemplo de la edición, en teoría el host listaría editar-prompt-de-agente, podría cargarla al ver una petición de cambio y solo después llamaría a la tool que guarda el prompt. El recorrido completo sería:
Los digests verifican que los bytes coinciden con la entrada de la skill, no que su autor sea confiable. La identidad combina origen y URI; el prefijo skill:// no acredita por sí mismo una skill.
Puede haber scripts entre los archivos. Transportarlos no autoriza ejecutarlos: el host necesita políticas y aislamiento.
Descubrir, cargar, activar, seguir y ejecutar son pasos distintos. La extensión no garantiza que una skill se active antes de cada tool ni que el modelo cumpla todas sus instrucciones.
El manual aconseja; el servidor garantiza
Una skill no obliga a nada: el modelo puede no cargarla, o cargarla y saltarse un paso. Con la edición del prompt, eso significa un cambio peor hecho, pero no un desastre, porque nuestro servidor valida cada edición antes de guardarla. WorkOS hace lo mismo con los borrados: el primer intento nunca borra nada, porque el servidor exige una confirmación aparte.
Si saltarse una instrucción rompe seguridad, consistencia o lógica de negocio, no puede existir solo en Markdown.
Hoy workaround; mañana contrato
Empezamos con una pregunta: ¿dónde debe vivir el manual para que viaje con las herramientas? Hoy no hay una respuesta correcta; cada organización lo resuelve a su manera. Logfire y n8n lo meten en una tool de referencia, Brain en init, WorkOS en un plugin y Vercel en su CLI. Todo eso funciona, pero son workarounds: acuerdos privados entre un servidor y los clientes que saben leerlos. Cambias de cliente y el manual se puede quedar por el camino.
Un contrato es otra cosa: un acuerdo que cualquier cliente entiende sin conocerte. Eso es lo que la SEP-2640 propone para el procedimiento. Y lo de antes no cambia: lo que no puede fallar no se negocia en ningún manual, lo garantiza el servidor.
¿Y dónde estamos? La especificación es final desde septiembre de 2026 y el SDK de Python ya tiene el código fusionado, pero los clientes que importan todavía no la usan: ni Claude ni Codex piden hoy skills/list a un servidor. En cuanto Claude y Codex la soporten oficialmente, seré de los primeros en probarla.
Fran, CTO de GuruSup, cuenta la otra cara en «Tu harness recuerda errores que el modelo ya no comete»: cuando el modelo aprende algo, parte del harness que construimos a su alrededor sobra. Con los estándares pasa igual. El día que el protocolo adopte este patrón, nuestro workaround caducará, y será una buena noticia.
Queda una pregunta abierta para cualquiera que mantenga un MCP: ¿dónde vive hoy tu manual, y qué se perdió la última vez que cambiaste de cliente?
guest@gurusup > /posts
guest@gurusup > /install · conecta Gurusup Brain a tus agentes
Empieza - gratis